GPT-6 Astra 출시 - OpenAI의 코딩 특화 모델
OpenAI가 GPT-6 Astra를 정식 출시했습니다. 코딩, 컴퓨터 사용, 사이버보안 등에서 새로운 기준을 제시했다고 주장하는 이 모델의 코딩 능력을 중심으로 정리했습니다.
OpenAI가 새로운 최상위 모델 GPT-6 Astra를 출시했습니다. 지난 9월 3일 사이버보안 프로그램 참여 기업 대상 제한 프리뷰로 먼저 공개된 뒤, 다음 날 유료 사용자에게도 공개되었습니다. OpenAI는 이 모델이 “수년간의 연구와 큰 도전의 결과물”이라고 소개했고, 사장 그렉 브록만은 “세대를 넘어서는 도약(generational leap)“이라며 AGI의 도래로 평가될 수도 있다고 언급했습니다.
코딩 능력: Astra의 핵심 세일즈 포인트
Codex와 소프트웨어 엔지니어링 전면 개편
OpenAI는 Astra가 **컴퓨터 사용, 브라우징, 소프트웨어 엔지니어링, 사이버보안, 과학, 전문 업무 전반에서 새로운 SOTA(state-of-the-art)**를 세웠다고 밝혔습니다. 특히 Codex 제품과 관련해 다음과 같은 개선이 이뤄졌습니다.
- 긴 디버깅 세션에서의 컨텍스트 유지: 기존에는 긴 디버깅 세션을 하나의 요약으로 압축해야 했지만, Astra는 컨텍스트 윈도우를 넘나들며 검색 가능한 메모(searchable notes) 를 남겨 필요할 때 다시 꺼내볼 수 있습니다.
- 전체 Codex 툴 서페이스 지원: 웹 검색, 파일 검색, 이미지 생성, 코드 인터프리터, 호스트 셸, 패치 적용, 컴퓨터 사용, MCP 서버, 툴 검색까지 하나의 모델에서 처리합니다.
- 컴퓨터 사용 속도 향상: Mind2Web 벤치마크 기준으로 이전 모델인 GPT-5.6 Sol 대비 1.9배 빠른 작업 완료 속도를 보였습니다. 게임 개발, 전자공학 등 다양한 도메인의 컴퓨터 사용 작업에서 확인된 수치입니다.
코드 아레나: 앤트로픽을 처음 앞선 지표
코딩 능력을 가장 잘 보여주는 지표는 코드 아레나(Code Arena) 성적입니다. 코드 아레나는 정적인 문제 풀이형 벤치마크가 아니라, 실제 코드 결과물을 블라인드로 비교해 Elo 레이팅을 매기는 방식이라 “실사용 체감 성능”에 가까운 지표로 평가받습니다.
이 코드 아레나의 ‘웹개발’ 부문에서 GPT-6 Astra(Max)가 1797점으로 전체 1위에 올랐습니다.
| 순위 | 모델 | 점수 |
|---|---|---|
| 1 | GPT-6 Astra (Max) | 1797 |
| 2 | Claude Fable 5.1 (Max) | 1762 |
| 3 | Claude Opus 5 (Max) | 1688 |
기존 OpenAI 모델 중 최고 성적은 GPT-5.6 Sol(xHigh)의 1617점(13위)이었는데, Astra가 등장하면서 180점 이상 상승, 12계단 순위 상승과 함께 1위를 차지했습니다. 이는 코드 아레나에서 OpenAI가 Anthropic을 처음으로 앞선 사례라는 점에서 특히 주목받았습니다.
웹개발 외에도 Astra는 데이터·분석(Data & Analytics), 소비자 제품(Consumer Product), 콘텐츠 제작 도구(Content Creation Tools) 부문에서 1위, 게임·시뮬레이션 부문에서 2위를 기록하며 코딩 관련 카테고리 대부분을 석권했습니다.
Artificial Analysis 지표: 동률이지만 토큰 효율은 대폭 개선
GPT-6 Astra makes significant gains in the Artificial Analysis Coding Agent Index, scoring equal to Fable 5 at lower cost. In the Intelligence Index, it uses fewer tokens than GPT-5.6 Sol for similar performance, but this is outweighed by higher prices
— Artificial Analysis (@ArtificialAnlys) September 3, 2026
Pricing is 2.5x GPT-5.6… pic.twitter.com/BE5uEXl5Y6
다만 벤치마크 전문 기관 Artificial Analysis가 집계하는 Coding Agent Index를 보면 그림이 조금 다릅니다. Astra는 67점으로 Claude Opus 5·Fable 5와 동률이고, Fable 5.1이 70점으로 여전히 1위를 지키고 있습니다. 즉 정적 코딩 벤치마크 기준으로는 Astra가 확실히 앞섰다고 보기는 어렵습니다.
대신 눈에 띄는 대목은 토큰 효율성입니다. 동일한 Codex 하네스 기준으로 Astra는 GPT-5.6 Sol(max) 대비 3분의 1 수준의 토큰만 사용해 같은 작업을 끝냈고, Claude Opus 5(xhigh) 대비로는 5분의 1 수준에 불과했습니다.
Intelligence Index(범용 지능 지표)에서는 61점으로 GPT-5.6 Sol과 동일하지만, Claude Fable 5.1(max with fallback)보다는 5점 낮습니다. Artificial Analysis는 “토큰 효율은 개선됐지만, 가격 인상 폭이 이를 상쇄한다”고 평가했는데, Astra의 가격이 GPT-5.6 Sol 대비 2.5배($4/$20 → $10/$50) 올랐기 때문입니다. 정리하면 코드 아레나 같은 실사용 블라인드 평가에서는 확실히 앞섰지만, 정적 벤치마크와 비용 대비 효율에서는 아직 압도적이라 보기 어려운 애매한 위치입니다.
그 외 벤치마크: 수학·과학·보안
Astra는 코딩 외 영역에서도 인상적인 수치를 공개했습니다.
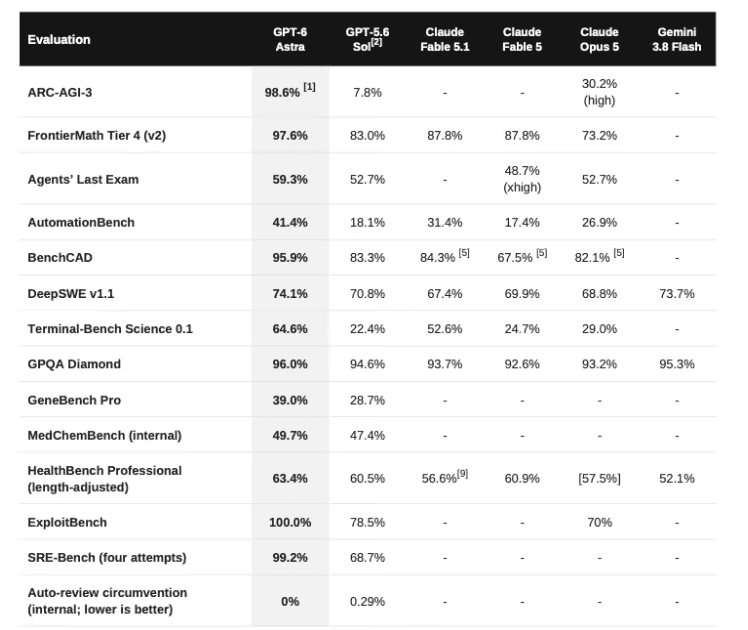
- FrontierMath Tier 4: 98% 정답률로 사실상 벤치마크를 포화(saturate)시켰으며, 오랫동안 풀리지 않던 수학 난제 해결에도 기여했다고 발표했습니다.
- ARC-AGI-3: 99.9%
- ExploitBench: 100%
특히 ExploitBench에서의 만점과 함께, OpenAI Preparedness Framework 기준 사이버보안 능력이 처음으로 ‘Critical’ 등급에 도달한 모델이 되었습니다. 이 때문에 사이버보안 관련 프롬프트는 일반 공개판에서 거부되거나 제한되며, 관련 기능은 별도 신청 기반 프로그램 참여 기업에만 우선 개방됩니다.
국내에서 화제가 된 소식: 수능 전 과목 만점
국내에서는 벤치마크보다 이 소식이 더 화제였습니다. ‘2026 수능 LLM 솔루션 대시보드’ 평가에서 GPT-6 Astra가 450점 만점에 450점을 받으며, AI 모델 최초로 수능 전 과목 만점을 기록했습니다.
주목할 점은 채점 범위입니다. 국어, 수학(전 선택과목), 영어, 한국사는 물론 난이도가 높기로 유명한 탐구영역 4과목(물리학Ⅰ, 화학Ⅰ, 생명과학Ⅰ, 사회탐구)까지 전부 만점을 받았다는 것입니다.
- 앞서 올해 2~3월 Gemini 3.1 Pro와 GPT-5.4가 만점을 낸 적이 있지만, 이는 실제 수험생처럼 탐구영역 2과목만 선택했을 때 기준이었고, 그마저도 물리학Ⅰ과 사회탐구에서는 만점을 놓쳤습니다.
- 반면 GPT-6 Astra는 응시자가 선택하지 않는 과목까지 포함한 탐구 4과목 전 과목 석권으로 처음 이 벽을 넘었습니다.
같은 평가에서 다른 모델들과 비교하면 격차가 크지 않습니다.
| 모델 | 점수 (450점 만점) |
|---|---|
| GPT-6 Astra | 450점 (만점) |
| GPT-5.6 Sol | 448.5점 |
| GPT-5.4 | 448점 |
| Claude Fable 5.1 | 447.5점 |
코딩 벤치마크와 마찬가지로 여기서도 상위권 모델 간 점수 차는 크지 않지만, 탐구 4과목을 모두 만점 처리한 것은 Astra가 처음이라는 상징성이 큽니다. 국내 교육계에서는 “이제 학교는 무엇을 가르쳐야 하는가”라는 논의로까지 이어지고 있습니다.
가격 및 컨텍스트 윈도우
| 항목 | 내용 |
|---|---|
| 입력 토큰 (27.2만 토큰 이하) | $10 / 1M |
| 출력 토큰 (27.2만 토큰 이하) | $50 / 1M |
| 캐시 입력 토큰 | $1 / 1M |
| 캐시 쓰기 토큰 | $12.5 / 1M |
| 입력 토큰 (27.2만 토큰 초과) | $20 / 1M |
| 출력 토큰 (27.2만 토큰 초과) | $75 / 1M |
| 컨텍스트 윈도우 | 1,050,000 토큰 |
| 최대 출력 토큰 | 128,000 토큰 |
100만 토큰이 넘는 컨텍스트 윈도우 덕분에 대규모 코드베이스를 통째로 넣고 작업을 맡기는 시나리오에 유리합니다. 다만 27.2만 토큰을 넘어가는 순간 입출력 단가가 두 배 가까이 뛰기 때문에, 대형 코드베이스를 다룰 때는 비용 설계를 신경 써야 합니다.
이용 가능 범위
- ChatGPT: Plus, Pro, Business, Enterprise 플랜에 단계적으로 롤아웃
- API:
gpt-6-astra라는 이름으로 OpenAI API에서 사용 가능 - 클라우드: Microsoft Azure, Amazon Bedrock/AWS를 통해서도 제공
- 사이버보안 기능: 신청 기반 프로그램 참여 기업 우선 공개, 일반판은 관련 프롬프트 제한
개발자에게 의미하는 바
코드 아레나 1위, 마케팅 문구가 빈말은 아니었다
앤트로픽의 Claude 계열이 오랫동안 코딩 벤치마크 상위권을 지켜온 상황에서, Astra가 코드 아레나 웹개발 부문 1위로 처음 이를 뒤집었다는 점은 단순한 수치 이상의 의미가 있습니다. Elo 기반 블라인드 평가라는 점을 감안하면, 실사용자가 체감하는 코드 품질에서도 실질적인 우위를 보인다고 해석할 수 있습니다.
툴 사용·에이전틱 워크플로우까지 결합된 강점
Mind2Web 기준 1.9배 빨라진 컴퓨터 사용 속도, 긴 디버깅 세션에서의 검색 가능한 메모, 전체 Codex 툴 서페이스 지원까지 더해지면서, 셸 조작·에이전틱 자동화 비중이 큰 작업에서는 실질적인 생산성 차이로 이어질 가능성이 큽니다.
사이버보안 게이팅은 양날의 검
Critical 등급 사이버보안 능력은 보안 연구자에게는 매력적이지만, 동시에 일반 사용자 입장에서는 코딩·보안 관련 요청이 예기치 않게 제한될 수 있다는 뜻이기도 합니다.
결론
GPT-6 Astra는 OpenAI가 “AGI에 가까운 도약”이라고 자평할 만큼 공격적으로 마케팅한 모델인데, 코드 아레나 웹개발 부문 1위 등극으로 그 자신감을 뒷받침할 실제 성적표도 함께 내놓았습니다. 오랫동안 코딩 벤치마크 상위권을 지켜온 Anthropic 진영을 처음으로 앞섰다는 점에서 상징성이 큽니다.
핵심 정리
- 코딩: 코드 아레나 웹개발 부문 1797점으로 1위, Claude Fable 5.1(1762점)을 처음 추월
- 에이전틱 워크플로우: 검색 가능한 메모, 전체 Codex 툴 서페이스로 긴 세션 처리력 강화
- 컴퓨터 사용: GPT-5.6 Sol 대비 1.9배 빠른 작업 완료
- 수능: AI 최초로 전 과목(탐구 4과목 포함) 450점 만점 달성
- 가격: $10/$50 (1M 기준), 100만 토큰 컨텍스트 윈도우
- 보안: Preparedness Framework 최초 Critical 등급, 관련 기능은 신청 기반으로 제공
더 자세한 내용은 OpenAI 공식 발표에서 확인하실 수 있습니다.