GPT-6 Astra 시대의 스킬·프롬프트 재설계 - OpenAI가 제안하는 방향
OpenAI가 공식 블로그를 통해 GPT-6 Astra에 맞춰 스킬(Skills)과 프롬프트를 다시 설계해야 하는 이유를 정리했습니다. 이전 모델을 위해 쌓아온 상세한 지침이 오히려 발목을 잡을 수 있다는 내용을 살펴봅니다.
지난 GPT-6 Astra 출시 포스팅에서는 코딩·수능 성적 등 벤치마크 위주로 살펴봤다면, 이번에는 OpenAI가 공식 블로그에 올린 Rethinking skills and prompts for GPT-6 Astra를 정리합니다. 모델이 더 똑똑해질수록 오히려 기존에 쌓아온 프롬프트·스킬 자산이 발목을 잡을 수 있다는, 실무자 입장에서 곱씹어볼 만한 내용입니다.
핵심 주장: “예전 방식의 정교한 지침이 이제는 비효율이다”
이전 세대 모델(GPT-5.6 Sol 등)을 다룰 때는 실수를 줄이기 위해 상세한 스캐폴딩(scaffolding)과 촘촘한 가이드를 프롬프트·스킬·AGENTS.md에 채워 넣는 것이 정석이었습니다. OpenAI는 이 글에서 GPT-6 Astra 같은 상위 모델에는 그 접근이 컨텍스트 낭비이자 성능 저하 요인이 될 수 있다고 지적합니다.
즉, 모델이 좋아졌다고 해서 기존 프롬프트를 그대로 두면 안 되고, 모델의 판단력이 좋아진 만큼 지침을 덜어내는 리팩터링이 필요하다는 것이 이 글의 요지입니다.
스킬은 “가이드북”이 아니라 “라우터”여야 한다
가장 눈에 띄는 개념은 점진적 공개(Progressive Disclosure) 입니다. 스킬 파일 자체가 모든 내용을 담은 매뉴얼이 될 필요는 없고, 필요한 상황에서 필요한 자료로 안내하는 최소한의 라우터 역할만 하면 충분하다는 주장입니다.
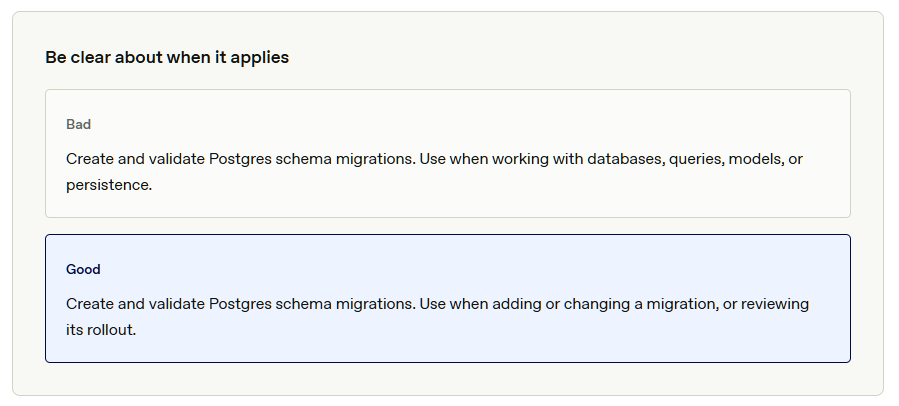
- 스킬 설명(description)은 넓은 트리거보다 구체적인 사용 시점으로 좁혀야 합니다.
- ❌ “데이터베이스 작업 시 사용”
- ✅ “마이그레이션을 추가하거나 변경할 때 사용”
- 스킬 안에 모든 내용을 다 적어두기보다, 필요할 때 참조할 수 있는 문서로 연결만 해두면 모델이 알아서 필요한 만큼만 찾아 읽습니다.
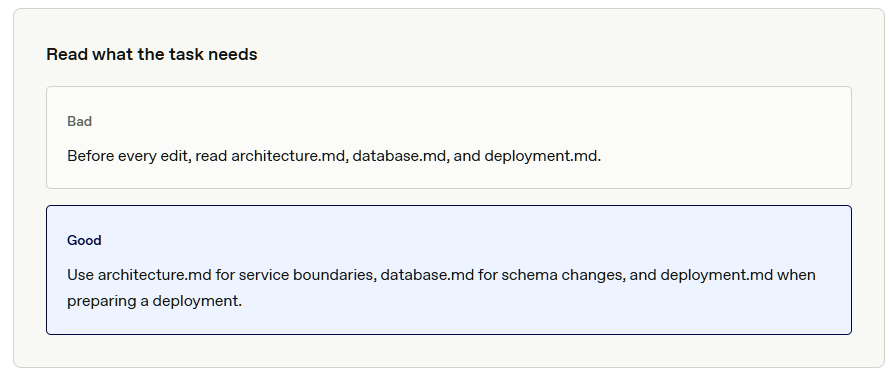
컨텍스트 효율성: “오타 하나 고치는데 리포 전체를 읽게 하지 마라”
OpenAI는 이렇게 표현합니다.
“Requiring a stack of docs or a full repo map before every edit is excessive for a typo fix.” (모든 수정 전에 문서 더미나 전체 리포 지도를 요구하는 것은 오타 하나 고치는 데도 과도하다.)
GPT-6 Astra는 스스로 필요한 정보가 무엇인지 판단할 수 있는 능력이 이전 모델보다 향상되었기 때문에, 작업 규모에 비례하지 않는 획일적인 사전 컨텍스트 요구는 오히려 비효율을 만든다는 것입니다.
모델마다 최적의 지침 스타일이 다르다
또 하나 강조하는 부분은 모델별 가이드 최적화입니다. GPT-5.6 Sol이나 이전 모델(Luna 등)에 맞춰 짜둔 상세 가이드를 GPT-6 Astra에 그대로 적용하면, 오히려 모델을 과도하게 제약(overconstrain) 하는 결과를 낳을 수 있다고 설명합니다. 모델 세대가 바뀔 때마다 프롬프트·스킬도 함께 재검토해야 한다는 실무적 시사점입니다.
AGENTS.md도 “무조건 읽어라”에서 “필요할 때 읽어라”로
AGENTS.md 같은 저장소 공통 지침 파일에 대해서도 구체적인 개선 방향을 제시합니다.
- 기존 방식: “작업 전 반드시 아래 문서를 모두 읽을 것” 식의 일괄 요구
- 권장 방식: 특정 작업과 연결된 조건부 포인터로 대체
- 예: “API 라우트를 수정할 때는
docs/api-conventions.md를 참고할 것”처럼 작업 맥락에 맞춰 필요한 문서만 안내
- 예: “API 라우트를 수정할 때는
이렇게 하면 관련 없는 작업에서까지 불필요한 문서를 읽느라 컨텍스트를 소모하지 않게 됩니다.
판단 경계(Decision Boundaries): 과도한 제약 풀어주기
이전 모델의 오남용을 막기 위해 넣어둔 제한적인 문구들이, 판단력이 좋아진 GPT-6 Astra에는 불필요한 신중함(과도한 확인 요청, 작업 회피) 을 유발할 수 있다는 지적도 있습니다. 모델이 스스로 합리적인 판단을 내릴 수 있는 영역이라면, 지침에서 그 재량을 존중하도록 손볼 필요가 있습니다.
작업 완료 기준을 명확히, 그리고 명시적으로 권한 부여
작업이 어디까지 끝나야 “완료”인지 사전에 명확한 기준을 정의하고, 필요한 작업(테스트 실행, 검증 등)을 수행할 권한을 명시적으로 부여해야 모델이 일을 절반만 하고 멈추는 것을 방지할 수 있다고 설명합니다. 이와 관련해 OpenAI가 인용한 문장이 인상적입니다.
“Previous models needed encouragement to run tests and check their work. GPT-6 Astra does that on its own.” (이전 모델들은 테스트를 돌리고 결과를 검증하도록 독려해야 했지만, GPT-6 Astra는 스스로 그렇게 한다.)
개발자에게 의미하는 바
1. 프롬프트·스킬도 “기술 부채”가 될 수 있다
이전 모델을 위해 정교하게 짜둔 지침이, 새 모델에서는 오히려 성능을 깎아 먹는 레거시가 될 수 있습니다. 모델을 업그레이드할 때 코드 리팩터링을 하듯 프롬프트·스킬·AGENTS.md도 함께 감사(audit) 하는 습관이 필요해 보입니다.
2. “더 자세히”가 항상 답은 아니다
지금까지는 실수를 줄이려면 지침을 더 촘촘하게 쓰는 방향으로 접근하는 경우가 많았습니다. 하지만 모델의 판단력 자체가 향상된 시점에는, 덜어내는 것이 오히려 더 나은 결과로 이어질 수 있다는 관점 전환이 필요합니다.
3. Progressive Disclosure는 Claude Code의 스킬 시스템과도 맞닿아 있다
스킬을 “라우터”로 쓰고 필요할 때만 세부 문서를 로드한다는 개념은, Claude Code의 스킬(Skill) 구조와도 방향성이 비슷합니다. 특정 벤더에 국한된 이야기가 아니라, 에이전틱 코딩 도구 전반에서 수렴하고 있는 설계 원칙으로 볼 수 있습니다.
결론
GPT-6 Astra의 벤치마크 성적만큼이나, 이 글이 짚은 **“모델이 좋아지면 지침도 가벼워져야 한다”**는 메시지는 실무에 바로 적용해볼 만한 포인트입니다. 특히 여러 세대의 모델을 거치며 쌓인 프롬프트·AGENTS.md·스킬 문서를 그대로 재사용하고 있다면, 한 번쯤 “이 지침이 지금 모델에도 필요한가?”를 점검해볼 시점입니다.
핵심 정리
- 점진적 공개: 스킬은 모든 걸 담은 매뉴얼이 아니라 필요한 자료로 안내하는 라우터로
- 컨텍스트 효율: 작업 규모에 맞지 않는 획일적인 사전 컨텍스트 요구는 비효율
- 모델별 최적화: 이전 모델용 가이드를 새 모델에 그대로 쓰면 과도한 제약이 될 수 있음
- AGENTS.md: 일괄 필독 지침 대신 작업 맥락에 연결된 조건부 포인터로
- 판단 경계: 향상된 모델 판단력에 맞춰 불필요한 제약 완화
- 완료 기준: 작업 완료 기준을 명확히 정의하고 필요한 작업 권한을 명시적으로 부여
더 자세한 내용은 OpenAI 공식 블로그에서 확인하실 수 있습니다.